Серверы с GPU для ускорения обучения ИИ и задач 3D рендеринга
25.10.2026 22:44 | Категория: Общие советыСервера с GPU – это вычислительные платформы, где графические процессоры используются не для игр, а для ускорения параллельных задач: обучения нейросетей, инференса, 3D-рендеринга, симуляций и обработки видео.
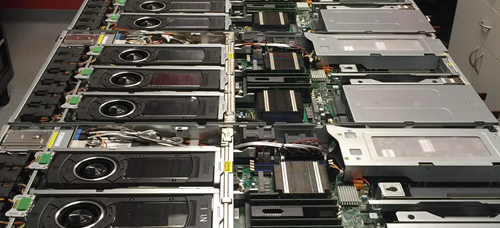
В отличие от классических CPU-серверов, vds gpu servers эффективно масштабируют производительность на задачах, где нужно одновременно выполнять тысячи однотипных операций.
Переход на GPU в серверной инфраструктуре позволяет сократить время итераций в проектах: быстрее обучать модели, оперативнее тестировать гипотезы, ускорять производство графики и визуальных эффектов. Это напрямую влияет на стоимость вычислений, сроки выпуска продукта и устойчивость нагрузки при росте числа пользователей или объёма данных.
Почему GPU дают выигрыш в ИИ и графике
Главная сила GPU – массовый параллелизм. Там, где CPU оптимален для сложной логики и последовательных вычислений, GPU берет количеством потоков и высокой пропускной способностью при работе с матрицами и тензорами. Именно поэтому глубокое обучение и рендеринг оказываются «родными» сценариями для GPU.
Ускорение задач машинного обучения
Современные модели ИИ опираются на линейную алгебру: перемножение матриц, свёртки, нормализации. GPU ускоряют эти операции за счёт специализированных блоков и оптимизированных библиотек. В результате время обучения сокращается с дней до часов, а иногда – до минут, что особенно критично при частых переобучениях и работе с большими датасетами.
Типовые ИИ-сценарии для GPU-серверов:
- обучение и дообучение нейросетей (CV, NLP, мультимодальные модели);
- инференс в реальном времени (чат-боты, рекомендации, поиск);
- пакетная обработка данных и генерация признаков;
- компьютерное зрение для видеопотоков и промышленной аналитики.
Ускорение рендеринга и производства контента
GPU-серверы востребованы в визуальных индустриях: архитектурной визуализации, игровой разработке, VFX и производстве рекламных роликов. Параллельная природа трассировки лучей, шейдинга и постобработки хорошо ложится на графические ускорители, позволяя получать кадры быстрее и увеличивать плотность задач на одну машину.
Где GPU особенно полезны в рендеринге:
- GPU-рендер движками, поддерживающими ускорение на видеокартах;
- превью и интерактивный рендер для быстрых правок;
- рендер-фермы, где важно масштабирование «по карточкам»;
- кодирование/транскодирование видео при потоковой обработке.
Типовые сценарии: обучение нейросетей, инференс, 3D?визуализация, видеокодирование
GPU?серверы дают заметный выигрыш там, где вычисления хорошо распараллеливаются: матричные операции в ИИ, трассировка лучей и шейдинг в 3D, массовая обработка кадров в видео. Типовой эффект – сокращение времени выполнения задач с часов до минут, а также возможность держать стабильную производительность при росте объёма данных и числа пользователей.
Выбор конфигурации стоит начинать не с «самой мощной видеокарты», а с профиля нагрузки: объём и тип VRAM, требуемая точность (FP32/FP16/BF16/INT8), пропускная способность PCIe/NVLink, ограничения по задержке, а также баланс CPU, RAM и быстрого хранилища. Ниже – четыре наиболее частых сценария и практические ориентиры по их настройке.
Обучение нейросетей (training)
Когда нужен GPU: при дообучении и полном обучении моделей, особенно с большими батчами, длинным контекстом и тяжёлыми аугментациями, где основная нагрузка – тензорные операции и обмен градиентами.
- Критично: объём VRAM (умещается ли модель + активации + оптимизатор), пропускная способность межсоединений между GPU (при multi?GPU), скорость чтения датасета.
- Полезные режимы: смешанная точность (FP16/BF16), градиентный чекпоинтинг, распределённое обучение (data/model/pipeline parallelism).
- Узкие места: «голодание GPU» из?за медленного CPU?препроцессинга и диска; недогруз из?за маленьких батчей и частых синхронизаций.
Практика: для стабильной загрузки GPU обеспечьте достаточный запас CPU-ядер под пайплайн данных, RAM под кэш, и NVMe для датасетов; для нескольких GPU заранее проверьте, поддерживает ли стек нужную схему параллелизма и как масштабируется скорость.
Когда нужен GPU: при обслуживании запросов к моделям (чат?боты, рекомендации, поиск, CV?сервисы), где важны либо минимальная задержка, либо высокая пропускная способность по QPS.
- Критично: VRAM под веса и KV?кэш, стабильная латентность, эффективность на низких точностях (INT8/FP8 где применимо), быстрый планировщик батчинга.
- Архитектурные приёмы: динамический батчинг, спекулятивный декодинг (если используется), квантизация, шардинг модели, выделение отдельных GPU под «горячие» модели.
- Узкие места: рост задержки из?за очередей, фрагментация VRAM, медленный обмен с CPU/сетевыми сервисами, конкуренция нескольких моделей за один GPU.
Практика: разделяйте профили «низкая задержка» и «высокий QPS» на уровне пулов ресурсов; измеряйте P50/P95/P99 и держите запас VRAM под пик, иначе деградация будет резкой.
Когда нужен GPU: при интерактивной визуализации и офлайн?рендеринге (архвиз, продуктовая графика, VFX), где GPU ускоряет трассировку лучей, денойзинг и финальный просчёт кадров.
- Критично: VRAM под сцены (геометрия, текстуры, кеши), поддержка аппаратного рейтрейсинга (если используется движком), пропускная способность памяти.
- Пайплайн: подготовка ассетов и симуляций часто упирается в CPU/RAM, а финальный рендер – в GPU; важно правильно разделить этапы.
- Узкие места: «не влезает в VRAM» (переход на медленный out?of?core), узкий PCIe при активном стриминге ассетов, нехватка RAM при больших кэшах.
Практика: планируйте сцены и текстурные пакеты под реальный объём VRAM, используйте прокси/LOD, а для фермы рендера – выделяйте очереди задач по типам проектов и требуемому объёму памяти.
Когда нужен GPU: при массовом транскодировании, live?стриминге, VOD?пакетировании, генерации превью и обработке видео (в т.ч. с фильтрами и ИИ?улучшениями).
- Критично: аппаратные кодеки/энкодеры, число параллельных потоков, баланс I/O (диск/сеть), устойчивость к пиковым нагрузкам.
- Сценарии: пакетное кодирование (throughput), live?кодирование (latency), гибридные цепочки (GPU?фильтры + аппаратный энкод).
- Узкие места: ограничение по количеству одновременных энкод?сессий, перегрев/троттлинг, упор в сеть при раздаче готового контента.
Практика: считайте производительность в «потоках на GPU» для ваших пресетов и разрешений; масштабируйте горизонтально, если важна предсказуемость и отказоустойчивость, и не забывайте про резерв пропускной способности хранилища.
Итог: один и тот же GPU?сервер может быть эффективным для разных задач, но только при правильном сопоставлении требований сценария с ресурсами: VRAM и тип точности – для ИИ, межсоединения и I/O – для обучения, латентность и управление батчингом – для инференса, объём сцены – для 3D, а ограничения энкодинга и потоков – для видео. Универсальная стратегия – измерять реальные метрики (время эпохи, QPS/latency, кадры/час, потоков/сек), выявлять узкие места и затем добавлять именно тот ресурс, который ограничивает производительность, а не «наращивать всё сразу».
Оставить комментарий